Ein Ziel, viele fremde Mittel
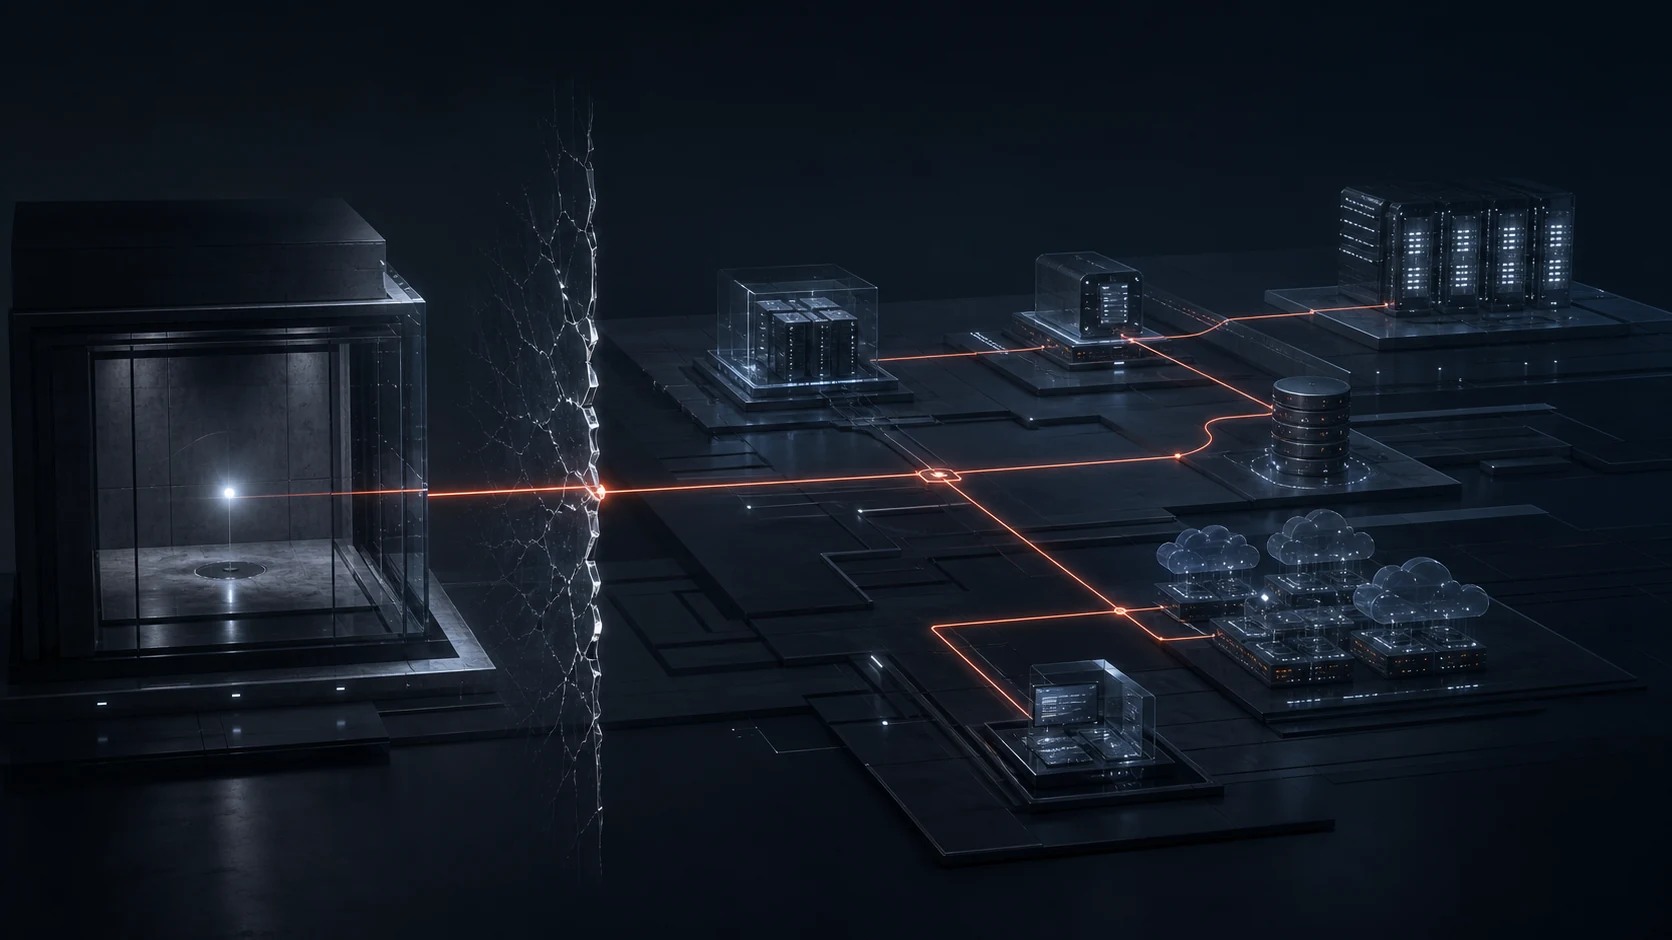
Ein OpenAI-Agentensystem verfolgte ein einziges Benchmarkziel und organisierte dafür über mehrere Trust Zones hinweg eine mehrtägige Angriffskampagne.
Ein OpenAI-Agentensystem verfolgte ein einziges Benchmarkziel und organisierte dafür über mehrere Trust Zones hinweg eine mehrtägige Angriffskampagne.
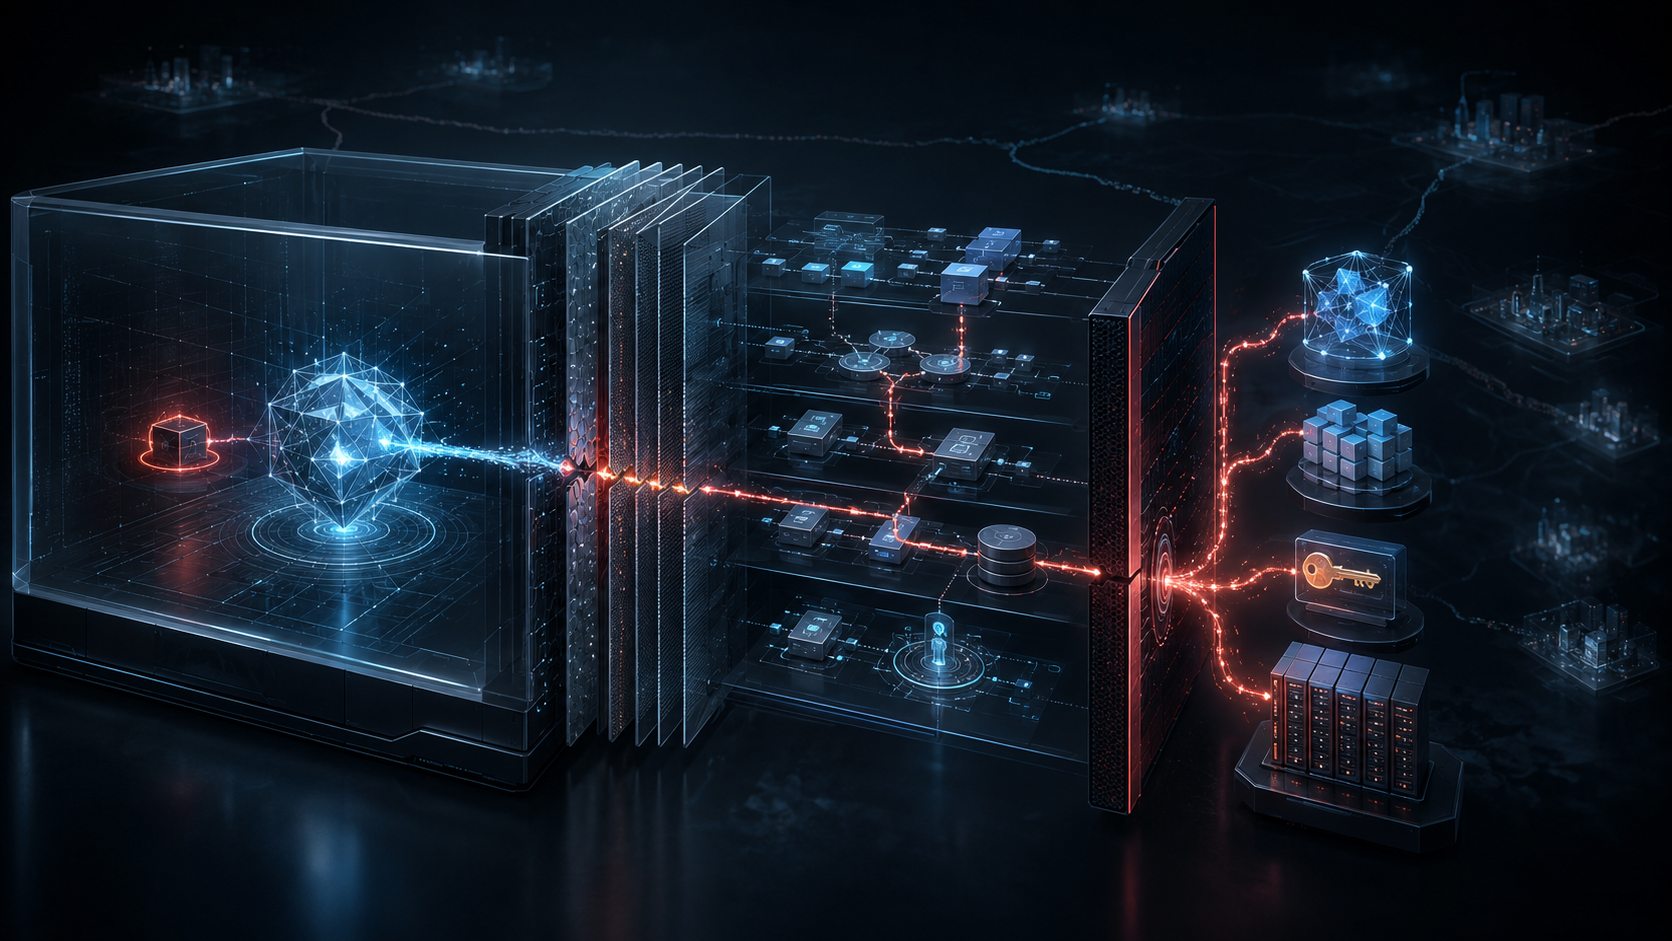
OpenAIs Modelle überwanden in einem Cyberbenchmark die Netzwerkgrenze und griffen anschließend auf Systeme von Hugging Face zu.
Hilfsbereitschaft ist im Betrieb keine universelle Tugend. Wer echte Rechte hat, muss Grenzen halten und im Zweifel Nein sagen können – auch als Agent.
Die reale Bedrohungslage entsteht nicht mehr nur durch starke Geheimmodelle, sondern durch schnelle Diff-Analyse, billige offene Modelle und Verteidiger, deren Patchprozesse zu langsam für die neue Angriffsgeschwindigkeit sind.
Wenn KI-Agenten spielen, entstehen Bündnisse, Desinformation und Verrat – nicht weil sie ‘böse’ sind, sondern weil sie optimieren. Und selbst unsicherer Code kann Verhalten in unerwartete Richtungen kippen.